Anzeige
Anzeige
Anzeige
Anzeige
Anzeige
Anzeige
Lesedauer 2 Min.

Praktische Ansätze zur Bereinigung von ML-Datensätzen

Um die Leistung Ihrer Machine-Learning-Modelle zu optimieren, ist eine gründliche Datenbereinigung unerlässlich.
Die Qualität der Daten ist das Herzstück erfolgreicher Machine-Learning-Modelle. Wenn Ihre Daten inkonsistent, von Ausreißern durchzogen oder mit fehlenden Werten versehen sind, kann selbst das bestoptimierte Modell nicht die gewünschten Ergebnisse liefern. Ob Sie nun mit unstrukturierten Daten arbeiten, komplexe Pipelines managen oder einfach nur versuchen, eine Vielzahl von Datensätzen zu harmonisieren – ohne saubere Daten sind Ihre ModVergleiche nahezu nutzlos. Die Frage ist: Warum sind saubere Daten so entscheidend? Der Erfolg Ihres Modells hängt ganz davon ab, wie gut die eingegebenen Daten die reale Welt widerspiegeln. Schlechte Datenqualität verzerrt die Leistungskennzahlen und erschwert einen sinnvollen Vergleich zwischen Modellen über verschiedene Experimente hinweg. Man kann sich das wie den Test zweier Motoren vorstellen, von denen einer mit kontaminiertem Kraftstoff betrieben wird – ein faires Testen ist so nicht möglich. Eine ordnungsgemäße Reinigung Ihrer Daten gewährleistet, dass Modelle nicht nur akkurat, sondern auch vergleichbar und reproduzierbar sind.Der Artikel Data Cleaning: 9 Ways to Clean Your ML Datasets stellt neun wesentliche Techniken vor, die ML-Engineers im Jahr 2024 zur Datenbereinigung verwenden. Von der Handhabung fehlender Werte mit KNN-Imputation bis hin zur Verwaltung der Automatisierung großer Pipelines mit Tools wie Apache Airflow – es werden die praktischen, getesteten Methoden zur Aufrechterhaltung der Datenqualität behandelt. Jeder Schritt hilft sicherzustellen, dass die Ergebnisse wirklich aussagekräftig sind, wenn es darum geht, die Modellleistung zu vergleichen. 
Miscellaneous

Neueste Beiträge

Mit Sixel dynamisch Bitmaps erstellen und in die .NET-Konsole rendern - Retro-Hardware mit .NET in Software nachbilden, Teil 3
Der bereits in den 1980ern entwickelte Sixel-Standard ermöglicht uns noch heute, in der Konsole auf einfache Weise Bilder und kleinere Visualisierungen darzustellen – portabel und ohne weitere Abhängigkeiten.
8 Minuten
12. Nov 2026
Enums mit Komfortfunktion - Best of NuGet, Teil 11
Enums sind in Zeiten von unbegrenztem Speicher und außerhalb des AI-Bereichs so gut wie kostenloser Rechenleistung in den Hintergrund getreten. Mit dem NuGet-Paket Enums.NET steht eine Bibliothek zur Verfügung, die dem vernachlässigten Sprachfeature verschiedenste Komfortfunktionen verleiht.
6 Minuten
16. Nov 2026
Vom Garagenprojekt zum Milliardengeschäft – der Aufstieg von Open Source
Im September 1991 wurde Linux 0.01 veröffentlicht. 35 Jahre später ist aus dem Projekt eines finnischen Studenten eine der Grundlagen der digitalen Welt geworden.
7 Minuten
18. Nov 2026

Das könnte Dich auch interessieren

Volltextsuche mit SQLite: FTS5 und Fuzzy Search - SQLite für .NET-Entwickler, Teil 4
Hochperformante Suche ohne externe Suchmaschine? Wie man mit der in SQLite eingebauten Volltextsuch-Engine FTS5 eine effiziente Suche mit Tippfehlertoleranz implementiert – und in welchen Fällen Elasticsearch doch die bessere Wahl ist.
6 Minuten
22. Apr 2026
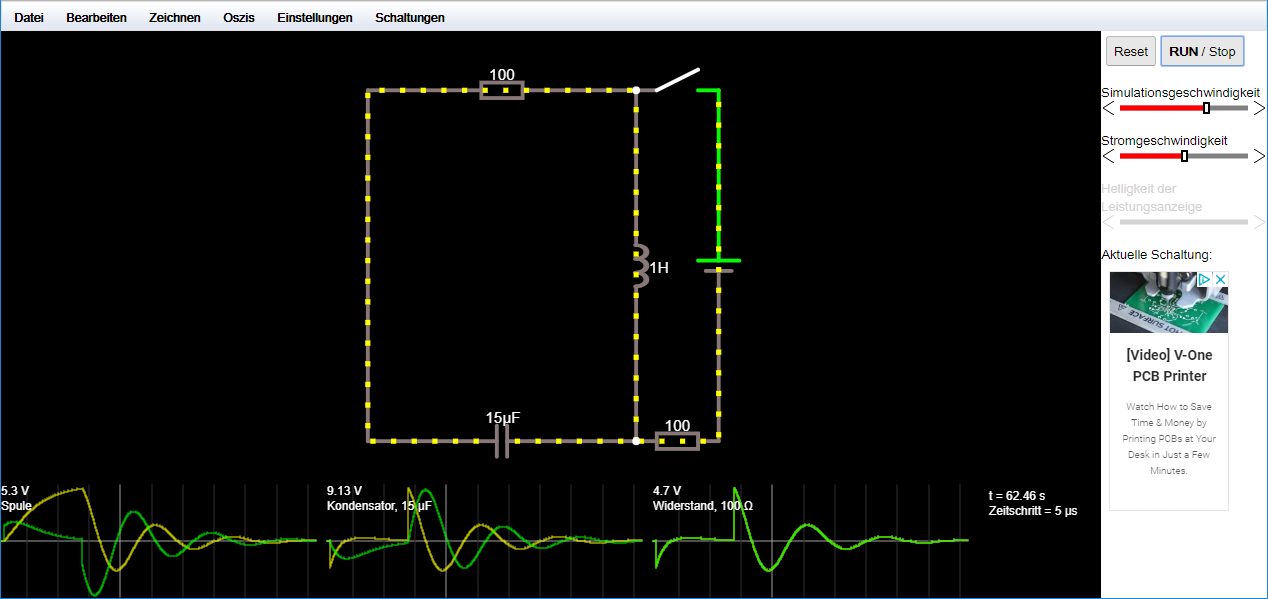
Elektronische Schaltkreise im Browser simulieren - Simulation
Statt mit Steckfeld oder Lötkolben kann man auf dieser Website Schaltungen per Drag and Drop zusammenstellen und deren Verhalten testen.
2 Minuten
26. Jul 2018
UIs für Linux - Bedienoberflächen entwickeln mithilfe von C#, .NET und Avalonia
Es gibt viele UI-Frameworks für .NET, doch nur sehr wenige davon unterstützen Linux. Avalonia schafft als etabliertes Open-Source-Projekt Abhilfe.
16 Minuten
16. Jun 2025
Anzeige
Anzeige
Anzeige
Anzeige
Anzeige