KI in Anwendungen mit Microsoft Graph
Connected Apps mit .NET, Teil 4
Generative KI wird in Anwendungen erst dann nützlich, wenn sie den Arbeitskontext des Benutzers kennt. Microsoft Graph liefert dafür Termine, E-Mails und Dokumente aus Microsoft 365. Dieser Beitrag zeigt, wie daraus mit .NET, Azure AI Search und einem Sprachmodell ein nachvollziehbares RAG-Szenario entsteht, und ergänzt damit den zugehörigen Leitartikel „Connected Apps mit .NET“ unter [1].
Ein Sprachmodell kann Texte formulieren, Informationen zusammenfassen oder Fragen beantworten. Was ihm zunächst fehlt, ist der konkrete Unternehmenskontext: Welche Termine stehen an, welche E-Mails gehören zu einem Vorgang und welche Projektdokumente sind relevant? Microsoft Graph stellt dafür nicht die KI bereit, sondern den kontrollierten Zugang zu Microsoft-365-Daten, mit denen eine Antwort fachlich verankert werden kann.
Das Prinzip ist das Folgende: Die .NET-Anwendung ermittelt über Microsoft Graph relevante Informationen aus Outlook, Kalender, OneDrive und SharePoint. Für größere Dokumentbestände ergänzt eine semantische Suche diesen Live-Kontext. Die gefundenen Inhalte werden an ein Sprachmodell übergeben. Dieses Vorgehen wird als Retrieval-Augmented Generation (RAG) bezeichnet. Dabei liefert Microsoft Graph nur Daten, auf welche die Anwendung im jeweiligen Benutzerkontext zugreifen darf. Die Anwendung filtert die fachlich benötigten Informationen, die Suche ermittelt daraus relevante Inhalte und das Sprachmodell generiert die Antwort (Bild 1).
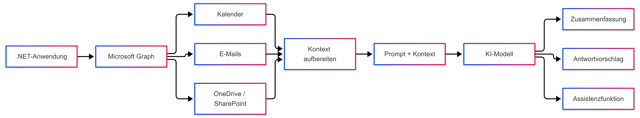
Microsoft Graph liefert Kalender-, Mail- und Dokumentdaten (Kontext) für die KI-Funktionen (Bild 1)
Autor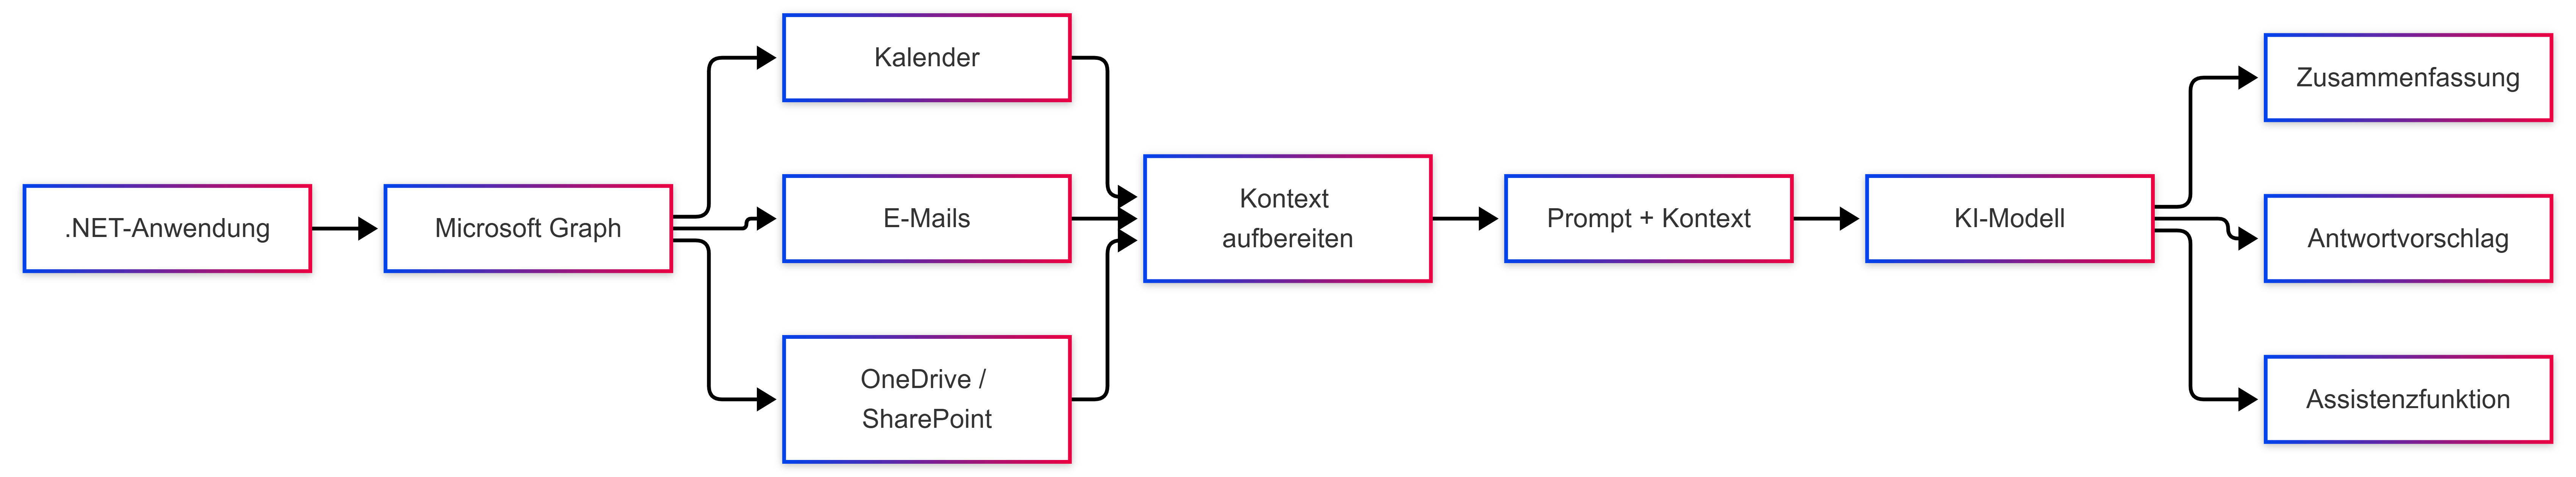
Ein Modell sollte dabei aus Gründen des Datenschutzes und der Datensicherheit nicht pauschal Zugriff auf ein ganzes Postfach oder eine komplette Dokumentbibliothek erhalten. Hier die Konfiguration für den Graph-Zugriff auf den benötigten Arbeitskontext:
private static readonly string[] Scopes =
[
    "User.Read",
    "Mail.Read",
    "Calendars.Read",
    "Files.Read",
    "Sites.Read.All"
];
var provider = new BaseBearerTokenAuthenticationProvider(
    new MsalAccessTokenProvider(this));
_graphClient = new GraphServiceClient(provider);
Die Scopes im Listing zeigen mehrere Datenbereiche, weil das Beispiel E-Mails, Termine und Dokumente kombiniert. Die Berechtigungen sind eng zu vergeben, beispielsweise sollte ein Assistent, der Kalenderdaten zusammenfasst, keinen Zugriff auf SharePoint haben. Das Prinzip der minimalen Rechte gilt für alle KI-Szenarien.
Arbeitskontext aus Microsoft 365 zusammenführen
Für einen KI-Assistenten ist es selten sinnvoll, große Datenmengen zu laden. Besser ist es, aus der Aufgabe abzuleiten, welche Informationen tatsächlich benötigt werden. Zur Vorbereitung eines Kundentermins können beispielsweise die nächsten Kalendereinträge, aktuelle E-Mails und ausgewählte Projektdokumente relevant sein. Die Graph-Daten werden dazu in ein gemeinsames, kleines Kontextmodell überführt. Dieses enthält neben dem Text auch Herkunft, Titel und gegebenenfalls einen Link zur Quelle. Die KI-Komponente muss dann nicht mehr wissen, ob ein Inhalt ursprünglich aus einer Outlook-Nachricht, einem Kalenderereignis oder einem SharePoint-Dokument stammt.
So werden E-Mails und Termine als gemeinsamer Arbeitskontext geladen:
public sealed record ContextItem(
    string Source, string Title, string Text, string? Url = null);
public async Task<List<ContextItem>> LoadWorkContextAsync(
        DateTimeOffset from, DateTimeOffset to,
        CancellationToken ct = default)
{
    var result = new List<ContextItem>();
    var mails = await _graphClient.Me.MailFolders["inbox"].Messages
        .GetAsync(cfg =>
        {
            cfg.QueryParameters.Select =
                ["subject", "from", "receivedDateTime", "bodyPreview"];
            cfg.QueryParameters.Orderby = ["receivedDateTime desc"];
            cfg.QueryParameters.Top = 10;
        }, ct);
    foreach (var mail in mails?.Value ?? [])
        result.Add(new("Mail", mail.Subject ?? "",
            mail.BodyPreview ?? ""));
    var events = await _graphClient.Me.CalendarView.GetAsync(cfg =>
    {
        cfg.QueryParameters.StartDateTime = from.ToString("o");
        cfg.QueryParameters.EndDateTime = to.ToString("o");
        cfg.QueryParameters.Select = ["subject", "start", "end", "location"];
    }, ct);
    foreach (var ev in events?.Value ?? [])
        result.Add(new("Kalender", ev.Subject ?? "",
            $"{ev.Start?.DateTime} - {ev.End?.DateTime}; " +
            $"Ort: {ev.Location?.DisplayName}"));
    return result;
}
Das Beispiel lädt nur wenige aktuelle Nachrichten und einen klar definierten Kalenderzeitraum. Mit $select werden ausschließlich die für den Kontext benötigten Eigenschaften angefordert. Anschließend kann die Fachlogik weiter filtern, etwa nach Absender, Zeitraum oder Vorgangsbezug. Je früher irrelevante Daten ausgeschlossen werden, desto kleiner und nachvollziehbarer bleibt der spätere KI-Aufruf. Mit anderen Worten: Der Kontext erweitert die Wissensbasis des Sprachmodels, gleichzeitig wird der Kontext auf die relevanten Daten eingeschränkt und damit die Wahrscheinlichkeit für ein Halluzinieren verringert.
Für Dokumente kommt eine zusätzliche Stufe hinzu. Microsoft Graph liefert Dateien und Metadaten, ein Sprachmodell benötigt aber in der Regel extrahierten Text. PDF-, Word- oder PowerPoint-Dateien werden deshalb über Graph geladen und anschließend mit einem passenden Parser oder beispielsweise Azure AI Document Intelligence in Text überführt.
Dokumente für semantische Suche vorbereiten
Kleine Mengen Kontext lassen sich direkt in einen Prompt einfügen. Bei großen SharePoint-Bibliotheken funktioniert das nicht mehr. Statt den gesamten Bestand an ein Sprachmodell zu senden, wird der Inhalt vorbereitet und durchsuchbar gemacht: Dateien laden, Text extrahieren, in Abschnitte zerlegen, Embeddings erzeugen und in einem Vektorindex speichern (Bild 2).

RAG-Architektur mit Microsoft Graph, Azure AI Search und einem Sprachmodell (Bild 2)
Autor
Die Suche soll nicht ein komplettes Handbuch oder Protokoll zurückgeben, sondern möglichst genau die passende Passage. Neben dem Text sollten deshalb Metadaten wie Quelldokument, DriveItem-ID, Web-URL und Änderungszeitpunkt gespeichert werden. Sie ermöglichen Quellenangaben und erleichtern die Aktualisierung des Index.
So wird das Graph-Dokument in indexierbare Textabschnitte zerlegt:
public sealed record AiChunk(
    string Id, string SourceId, string Title,
    string Content, string? WebUrl);
public async Task<IReadOnlyList<AiChunk>> PrepareDocumentAsync(
        string driveId, string itemId, string title,
        string? webUrl, CancellationToken ct = default)
{
    using var stream = await _graphClient.Drives[driveId]
        .Items[itemId].Content.GetAsync(cancellationToken: ct);
    var text = await ExtractTextAsync(stream!, title, ct);
    return SplitIntoChunks(text, size: 1800, overlap: 200)
        .Select((part, index) => new AiChunk(
            $"{itemId}-{index}", itemId, title, part, webUrl))
        .ToList();
}
Die Hilfsmethoden ExtractTextAsync() und SplitIntoChunks() sind anwendungsspezifisch. Bei Office- und PDF-Dokumenten hängt die Extraktion vom verwendeten Parser ab. Eine Überlappung benachbarter Abschnitte verhindert, dass Zusammenhänge an einer Chunk-Grenze verloren gehen.
Was ist ein Chunk?
Ein Chunk ist ein kleiner Textabschnitt, in den ein größeres Dokument zerlegt wird, bevor es für Suche oder KI-Verarbeitung verwendet wird. Ein Beispiel: Ein PDF mit 40 Seiten wird nicht als ein einziger großer Text verarbeitet, sondern etwa in Abschnitte von einigen Hundert Wörtern zerlegt. Jeder dieser Abschnitte ist ein Chunk.
Warum macht man das? Bei RAG soll nicht immer das komplette Dokument an das Sprachmodell geschickt werden. Stattdessen werden nur die inhaltlich passenden Chunks zur Benutzerfrage gesucht und anschließend als Kontext an das KI-Modell übergeben.
Für die Suche eignet sich ein Vektorindex wie Azure AI Search. Für jeden Abschnitt wird ein Embedding gespeichert, also eine numerische Repräsentation seiner Bedeutung. Auch die Benutzerfrage wird vektorisiert. So lassen sich semantisch passende Passagen finden, selbst wenn andere Begriffe verwendet werden. In der Praxis ist eine hybride Suche aus Volltext- und Vektorsuche oft hilfreich:
var vectorQuery = new VectorizableTextQuery(question)
{
    KNearestNeighborsCount = 5
};
vectorQuery.Fields.Add("contentVector");
var options = new SearchOptions
{
    Size = 5,
    VectorSearch = new()
};
options.VectorSearch.Queries.Add(vectorQuery);
options.Select.Add("title");
options.Select.Add("content");
options.Select.Add("webUrl");
SearchResults<SearchDocument> hits =
    await _searchClient.SearchAsync<SearchDocument>(
        question, options, ct);
Die Suche liefert bewusst nur wenige Treffer. RAG bedeutet nicht, möglichst viele Unternehmensdaten in den Prompt zu kopieren, sondern einen kleinen, passenden Kontext zu ermitteln. Berechtigungen dürfen dabei nicht verloren gehen: Ein Suchindex darf keine Inhalte an Benutzer ausliefern, die diese in SharePoint nicht lesen dürften. Zugriffsregeln müssen deshalb beim Retrieval berücksichtigt oder vor der Übergabe an das Modell erneut geprüft werden.
RAG: Aus gefundenem Kontext eine Antwort erzeugen
Nach dem Retrieval setzt die Anwendung die gefundenen Textabschnitte zu einem Kontext zusammen und übergibt ihn gemeinsam mit der Benutzerfrage an ein Sprachmodell. Das Modell erhält damit keine unbeschränkte Sicht auf Microsoft 365, sondern nur die zuvor ausgewählten Informationen. Quellen können mitgeführt und später in der Antwort ausgegeben werden.
Für .NET bietet sich Microsoft.Extensions.AI als Abstraktion über den Modellclient, beispielsweise Azure OpenAI und Microsoft Entra ID. Für in Azure betriebenen Anwendungen kann eine Managed Identity eingesetzt werden, sodass kein API-Schlüssel im Quellcode oder in einer Konfigurationsdatei gespeichert werden muss.
Ein Chat-Client für Azure OpenAI wird folgendermaßen bereitgestellt.
IChatClient chatClient =
    new AzureOpenAIClient(
        new Uri(endpoint),
        new DefaultAzureCredential())
    .GetChatClient(deployment)
    .AsIChatClient();
Der Prompt sollte festlegen, dass die Antwort auf den gelieferten Kontext beschränkt bleibt, Unsicherheiten kenntlich gemacht und Quellen verwendet werden. So wird aus einer allgemeinen Chat-Funktion ein fachlich kontrollierter Assistent.
Der gefundene Kontext lässt sich in folgender Weise für eine RAG-Antwort verwenden:
string context = string.Join("\n\n---\n\n",
    chunks.Select(c =>
        $"Quelle: {c.Title}\nURL: {c.WebUrl}\n{c.Content}"));
string prompt = $"""
Beantworte die Frage ausschließlich auf Basis des Kontextes.
Wenn die Informationen nicht ausreichen, sage das ausdrücklich.
Nenne die verwendeten Quellen am Ende der Antwort.
Frage:
{question}
Kontext:
{context}
""";
ChatResponse response = await _chatClient.GetResponseAsync(
    prompt, cancellationToken: ct);
return response.Text;
Das Beispiel zeigt das klassische RAG-Muster ohne zusätzliche Agentenlogik: Die Anwendung kontrolliert Retrieval, Prompt und Datenfluss selbst. Azure AI Search bietet auch weitergehende RAG- und agentische Retrieval-Funktionen. Das Grundprinzip bleibt jedoch gleich: Zuerst wird berechtigter und relevanter Kontext bestimmt, danach erzeugt das Modell daraus eine Antwort.
Zusätzlich können aktuelle Graph-Daten direkt in den Prompt einfließen. Ein Assistent zur Vorbereitung eines Kundentermins kann die nächsten Termine live über calendarView laden, relevante E-Mails aus Outlook ergänzen und über Azure AI Search passende Projektunterlagen finden. Daraus lassen sich beispielsweise Agenda, zuletzt besprochene Punkte und offene Aufgaben zusammenstellen.
Vom Prototyp zum sicheren Assistenzsystem
Für produktive Anwendungen muss zwischen aktuellen Live-Daten und indexierten Daten unterschieden werden. Kalender und E-Mails können bei Bedarf direkt über Graph geladen werden. Dokumentbestände werden häufig asynchron indexiert. Delta Queries und Change Notifications eignen sich dazu, Änderungen zu erkennen und nur betroffene Inhalte neu aufzubereiten.
Ebenso wichtig ist die Einhaltung des Prinzips der Datenminimierung. Ein Prompt sollte nicht vorsorglich komplette E-Mail-Verläufe oder umfangreiche Dokumente enthalten. Verarbeitet wird nur, was für die konkrete Funktion erforderlich ist. Auch im Suchindex gespeicherte Texte benötigen passende Zugriffsregeln, Aufbewahrungsfristen und Löschmechanismen; Zugriffstoken oder unnötige vollständige Inhalte gehören nicht in Logs. Inhalte aus E-Mails und Dokumenten sind Daten, keine vertrauenswürdigen Instruktionen für die KI-selbst. Ein Dokument kann Text enthalten, der wie eine Anweisung an das Modell formuliert ist. Die Anwendung sollte deshalb Systemregeln und fachliche Daten klar trennen, Antworten validieren und kritische Aktionen nicht allein aus generiertem Text ableiten.
Für Aktionen empfiehlt sich ein Human-in-the-Loop-Muster. Die KI kann eine Antwortmail, einen Terminvorschlag oder einen Freigabelink vorbereiten. Das tatsächliche Versenden einer E-Mail, Ändern eines Termins oder Freigeben eines Dokuments sollte jedoch bewusst bestätigt werden. Graph stellt die Operationen bereit, und die Fachanwendung entscheidet, wann sie ausgeführt werden.
Fazit
Microsoft Graph und generative KI ergänzen sich auf unterschiedliche Weise. Graph liefert Identität, Berechtigungen und Arbeitskontext aus Microsoft 365; ein Sprachmodell formuliert daraus Antworten. Für größere Dokumentbestände schließt Azure AI Search die Lücke: Aufbereitete Inhalte werden indexiert und pro Frage nur die relevanten Abschnitte an das Modell übergeben. Damit entsteht mehr als ein allgemeiner Chatbot. Eine .NET-Anwendung kann Termine, E-Mails und Dokumente zu einem Vorgang zusammenführen, semantisch nach relevanten Informationen suchen und daraus eine nachvollziehbare Antwort mit Quellen erzeugen. Entscheidend ist nicht möglichst viel Kontext, sondern der richtige Kontext: minimal berechtigt, fachlich gefiltert und aktuell.
[1] Veikko Krypczyk, Connected Apps mit .NET, dotnetpro 4/2026, Seite 36 ff.