Kostenkontrolle bei KI-Coding-Agenten
KI-gestützte Entwicklungswerkzeuge verändern eine ganze Disziplin. Viele Unternehmen experimentieren bereits mit Coding Agents – doch eine kritische Frage bleibt oft unbeantwortet: Wie kalkuliere ich die realen Kosten? Dieser Artikel liefert vier Strategien und wertvolle Tipps für die Praxis.
KI-Coding-Agenten verändern die Softwareentwicklung grundlegend. Sie analysieren Repositories, schlagen Refactorings vor, generieren Tests und modernisieren Legacy-Anwendungen. Das steigert die Produktivität und entlastet Entwickler von Routineaufgaben. Gleichzeitig entsteht eine neue Kostenrealität: Viele Unternehmen starten mit KI-Coding experimentell, erleben schnelle Erfolge – und werden wenige Wochen später von deutlich höheren Ausgaben überrascht. Der sogenannte „Token-Schock“ zeigt, dass KI-Effizienz ohne Kostenkontrolle teuer werden kann.
Token-Schock statt KI-Wonderland
Besonders bei Token-basierter Abrechnung können aus vielen kleinen Interaktionen schnell relevante Beträge werden. Ein Entwickler, der mehrere Agentenläufe pro Tag startet, große Repositories in den Kontext lädt, mehrfach mit Premium-Modellen iteriert und Build-Fehler durch wiederholtes Prompting lösen lässt, kann mehr Ressourcen verbrauchen als ursprünglich geplant. Ein KI-Coding-Agent kann schnell zu vier- bis fünfstelligen monatlichen Kosten führen.
Das ist kein Randthema. Das IBM Institute for Business Value geht davon aus, dass die durchschnittlichen Compute-Kosten innerhalb der nächsten 24 Monate um 89 Prozent steigen; 70 Prozent der befragten Führungskräfte nennen generative KI als wichtigen Treiber dieser Entwicklung. Für CTOs, Projektmanager und Entwicklungsteams bedeutet das: KI-Coding muss nicht nur technisch, sondern auch ökonomisch gestaltet werden. Die zentrale Frage lautet nicht mehr allein: „Kann der Agent diese Aufgabe lösen?“ Sondern: „Kann er sie in der richtigen Qualität, mit vertretbarem Ressourcenverbrauch und nachvollziehbaren Kosten lösen?“
Das Token-Paradoxon verstehen
Um KI-Kosten zu kontrollieren, muss zunächst klar sein, wo sie entstehen. Viele LLM-Anbieter rechnen nach Tokens ab – Textfragmente aus Prompts, Repository-Kontext und Antworten. Je größer der Kontext und je mehr Iterationen, Tool-Aufrufe oder Testläufe, desto höher die Kosten. Coding-Agenten sind besonders ressourcenintensiv, da sie Code analysieren, Abhängigkeiten verstehen, Builds und Tests ausführen und Änderungen über mehrere Dateien hinweg koordinieren. Das führt zu einem Effizienz-Dilemma: Große Modelle mit großen Kontextfenstern bieten zwar mehr Leistungsfähigkeit und können umfangreiche Zusammenhänge verarbeiten. Für viele Routineaufgaben ist diese Kapazität jedoch nicht erforderlich. Bei Code-Formatierungen, Syntax-Updates oder Unit-Tests erzielen kleinere Modelle häufig vergleichbare Ergebnisse – bei deutlich geringerem Token-Verbrauch und niedrigeren Kosten. Entscheidend ist deshalb, für jede Aufgabe das angemessene Modell auszuwählen, statt standardmäßig das Leistungsstärkste einzusetzen.
Intelligentes Model-Routing
Ein wirksamer Hebel zur Kostenkontrolle ist intelligentes Model-Routing. Statt jede Anfrage an dasselbe Modell zu schicken, klassifiziert eine Agentenarchitektur zunächst die Aufgabe und wählt ein passendes Modell. Kleinere Open-Source- oder kommerzielle Modelle können für klar abgegrenzte Aufgaben ausreichen. Leistungsstärkere Modelle sollten für komplexe Analysen, mehrdeutige Anforderungen oder risikoreiche Änderungen reserviert bleiben. Neben der Modellgröße muss die Kombination aus Modellfähigkeit, Kontextbedarf, Latenz, Datenschutzanforderungen und Kostenprofil in Einklang gebracht werden. Ein typisches Routing könnte so aussehen:
- Low Complexity: Formatierung, einfache Umbenennungen, kleine Testfälle, Kommentarentwürfe
- Medium Complexity: lokale Refactorings, Migration einzelner APIs, Build-Fehleranalyse
- High Complexity: Architekturänderungen, Legacy-Modernisierung, Sicherheitsanalysen, Änderungen über mehrere Services hinweg
Entscheidend ist, dass die Agentenplattform Aufgaben nicht blind weiterreicht, sondern vorab bewertet. Das kann regelbasiert beginnen und später durch Metriken wie Anzahl betroffener Dateien oder Kritikalität des Moduls verfeinert werden. In Entwicklungsplattformen wie IBM Bob (Bild 1) spielt diese Orchestrierung eine zentrale Rolle.
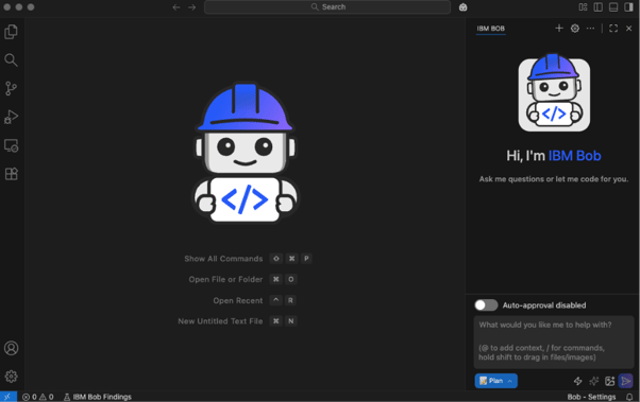
IBM-Bob-Startbildschirm (Bild 1)
Autor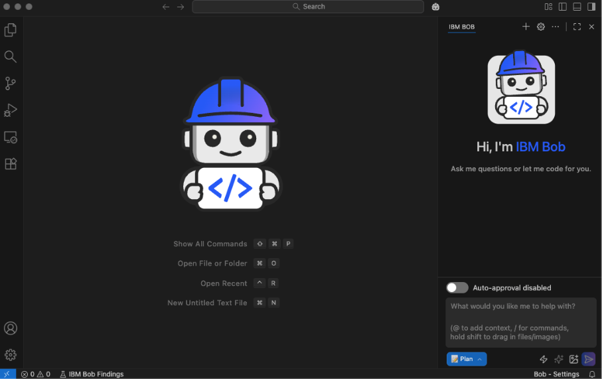
Kontext optimieren, statt alles mitzuschicken
Der zweite große Kostenhebel liegt im Kontextmanagement. Viele ineffiziente Agentenläufe entstehen, weil zu viel irrelevanter Kontext an das Modell gesendet wird. Große Repositories, lange Logdateien, komplette Konfigurationen oder mehrere ähnliche Fehlermeldungen werden in den Prompt kopiert, obwohl nur ein kleiner Ausschnitt relevant ist. Gutes Kontextmanagement bedeutet, den Kontext bewusst zu kuratieren. Der Agent sollte nicht „alles“ lesen, sondern die richtigen Artefakte identifizieren.
Auch Prompt-Engineering ist für das KI-Kostenmanagement kein kosmetisches Thema, sondern ein wertvoller Hebel. Ein präziser Prompt reduziert Rückfragen, Fehlinterpretationen und Wiederholungsschleifen. Für Entwicklerteams empfiehlt es sich, wiederkehrende Aufgaben als Prompt-Templates zu standardisieren: etwa für API-Migrationen, Unit-Test-Erweiterungen, Dependency-Upgrades oder Security-Fixes. Eine Faustregel lautet: Der Prompt sollte nicht möglichst lang, sondern möglichst entscheidungsrelevant sein. Für eine Migration von .NET Framework auf .NET 8 braucht ein Agent andere Informationen als für das Ergänzen eines Unit-Tests. Kontext ist kein kostenloser Rohstoff, sondern Teil der Kostenstruktur.
Caching ist ein weiterer Baustein. Prompt Caching kann die Kosten wiederkehrender LLM-Anfragen senken. Dabei berechnen viele Anbieter Prompt-Bestandteile günstiger, wenn sie innerhalb eines kurzen Zeitfensters erneut übermittelt werden. Dieser Mechanismus ist in der Regel nicht manuell steuerbar, sondern sollte vom Coding-Tool automatisch genutzt werden. Entscheidend ist daher, dass Tools wie IBM Bob wiederkehrenden Repository- und Projektkontext effizient handhaben, statt ihn bei jedem Agentenlauf vollständig neu zu verarbeiten.
Transparente Abrechnungsmodelle schaffen
Für einzelne Entwickler ist Token-basierte Abrechnung oft abstrakt, für Budgetverantwortliche hingegen schwierig planbar. Wenn Kosten direkt mit Promptlänge, Kontextgröße, Modellwahl und Iterationszahl schwanken, lässt sich ein Projektbudget nur schwer vorab kalkulieren. Das führt entweder zu übermäßig engen Nutzungslimits, die Produktivität bremsen, oder zu offenen Budgets, die später für Überraschungen sorgen.
Eine Alternative sind Credit- oder kontingentbasierte Modelle, bei denen Teams ein definiertes Budget für bestimmte Nutzungseinheiten erhalten. Dies senkt zwar nicht die Compute-Kosten, aber diese lassen sich besser planen.
Auch unproduktive Agents müssen auf den Prüfstand: Ein Agent, der nach mehreren Iterationen keinen brauchbaren Pull Request erzeugt, verursacht trotzdem Kosten. Deshalb sollten Plattformen nicht nur Nutzung messen, sondern auch die Ergebnisqualität betrachten.
Ein Beispiel für messbare Ergebnisse liefert Blue Pearl. Das Unternehmen modernisierte mit der Plattform IBM Bob eine Java-Codebasis und schloss ein Java-Upgrade in drei Tagen ab – verglichen mit rund 30 Tagen bei ähnlichen Vorhaben. Laut IBM wurden dadurch mehr als 160 Engineering-Stunden für höherwertige Arbeit erhalten, und der Delivery-Zyklus wurde um rund 90 Prozent beschleunigt. Solche Fallbeispiele zeigen, was für ein effizientes Kostenmanagement relevant ist, weil sie nicht nur die Tool-Nutzung berücksichtigen, sondern Ergebnis und Aufwand gegenüberstellen.
Agentendesign für Effizienz
Kostenkontrolle ist nicht nur eine Frage des Pricings, sondern auch des Agentendesigns. Ineffiziente KI-Agenten erzeugen unnötige Schleifen: Änderungen führen zu Build-Fehlern, Fehlermeldungen werden erneut verarbeitet, weitere Abhängigkeiten übersehen – jeder Durchlauf kostet Tokens, Zeit und Aufmerksamkeit. Effiziente Agenten sollten deshalb eng in Entwicklungswerkzeuge integriert sein und Build-Outputs, Testberichte, Linter-Ergebnisse und statische Analysen gezielt auswerten. Statt bei jedem Fehler den gesamten Kontext neu zu verarbeiten, analysieren sie nur die relevanten Änderungen und Fehlermeldungen.
Ebenso wichtig sind intelligente Retry-Strategien: Statt denselben Ansatz mehrfach zu wiederholen, wechseln sie zwischen lokaler Reparatur, Dependency-Prüfung, Rollback oder der Eskalation an ein leistungsfähigeres Modell oder einen Entwickler. Klare Abbruchregeln verhindern unnötigen Ressourcenverbrauch. Für wiederkehrende Aufgaben wie API-Modernisierungen reduziert Batch-Processing den Token-Verbrauch zusätzlich, indem Änderungen auf Basis einer validierten Transformationsstrategie effizient auf viele ähnliche Fälle übertragen werden.
Aus Entwicklersicht ist dabei vor allem entscheidend: Ein Coding-Agent darf nicht als Blackbox arbeiten. Er muss nachvollziehbare Zwischenschritte liefern, Änderungen erklären, Tests ausführen und bei Unsicherheit gezielt nachfragen. Der Mensch als letzte Instanz für Entscheidung darf nicht aus Kostengründen übergangen werden.
Governance und Sicherheit als Teil der Kostenrechnung
Bei KI-Coding gehören Produktivität und Governance untrennbar zusammen. Ein vermeintlich günstiges Tool kann teuer werden, wenn sensible Quellcodes an externe Dienste gelangen, Lizenz- oder Compliance-Risiken entstehen oder generierter Code aufwendig nachgeprüft werden muss. Unternehmen sollten KI-Coding-Agenten daher als Bestandteil der Software-Lieferkette bewerten. Wichtige Fragen sind:
- Wo werden Prompts und Code verarbeitet?
- Welche Modelle kommen zum Einsatz?
- Werden Daten gespeichert oder für das Training genutzt?
- Gibt es Rollen- und Rechtekonzepte, Audit-Trails sowie nachvollziehbare Modell- und Tool-Entscheidungen?
Ob Public Cloud, Private Cloud, On-Premises oder Hybrid wirtschaftlicher ist, hängt von Infrastruktur-, Betriebs-, Sicherheits- und Skalierungskosten ab. Governance sollte deshalb von Beginn an Teil der KI-Strategie sein. Wer Modellzugriffe steuert, sensible Repositories schützt und Review- sowie Compliance-Prozesse integriert, reduziert Risiken und vermeidet kostspielige Nacharbeit. IBM verweist bei Bob unter anderem auf Governance-Checkpoints, CI/CD-Validierung und die Unterstützung komplexer Modernisierungsszenarien.
Metriken: Was Teams wirklich messen sollten
Nutzungsmetriken wie Prompts, Tokens oder Modellaufrufe zeigen nur den Verbrauch. Entscheidend ist der geschaffene Wert: Kosten pro akzeptiertem Pull Request, behobenem Fehler oder modernisierter Komponente sowie der Anteil erfolgreicher Agentenläufe ohne Nacharbeit. So wird sichtbar: Nicht der günstigste Lauf ist am wirtschaftlichsten, sondern der mit dem besten Ergebnis.
Auch die von IBM veröffentlichten Produktivitätszahlen zu Bob sollten in diesem Sinn gelesen werden: IBM berichtet, dass mehr als 150.000 Mitarbeitende Bob nutzen und befragte Nutzer eine durchschnittliche Produktivitätssteigerung von 45 Prozent angeben. Befragte Entwickler des IBM-Instana-Teams berichteten zudem von einer durchschnittlichen Reduzierung des Zeitaufwands für ausgewählte Aufgaben um 70 Prozent und einer durchschnittlichen Zeitersparnis von 10 Stunden pro Woche.
Handlungsempfehlungen für Entwicklerteams und CTOs
Kostenkontrolle beginnt im Entwicklungsalltag. Teams sollten wiederkehrende Muster standardisieren: Welche Prompts funktionieren? Welche Kontexte sind nötig? Wann reicht ein kleineres Modell, wann braucht es menschliches Review? CTOs und technische Entscheider schaffen dafür die Rahmenbedingungen: Budgets, Modellrichtlinien, Governance, Metriken und Plattformstrategien. KI-Coding sollte nicht nur über Lizenzkosten bewertet werden, sondern über Produktivität, Qualität, Geschwindigkeit und Modernisierungspotenzial. Ein pragmatischer Einstieg umfasst fünf Schritte: Use Cases mit klaren Kriterien auswählen, Kosten und Ergebnisse messen, Model-Routing etablieren, Kontexte durch Templates und Caching optimieren sowie Governance direkt in den Entwicklungsprozess integrieren. So wird KI-Coding skalierbar und wirtschaftlich nutzbar.
Fazit: Nachhaltige KI-Entwicklung ist gestaltbar
KI-Coding-Agenten werden bleiben. Entscheidend ist nicht, ob Unternehmen sie einsetzen, sondern wie professionell sie den Einsatz organisieren. Wer nur auf kurzfristige Produktivität setzt, riskiert steigende Kosten, Sicherheitsprobleme und enttäuschte Erwartungen. Nachhaltige KI-Entwicklung bedeutet: das passende Modell für die Aufgabe, gezieltes Kontextmanagement, transparente Kosten und klare Governance. Für Entwickler ist Kostenkontrolle dabei kein kaufmännisches Thema, sondern ein technisches Designprinzip (Bild 2). Effiziente Agentenarchitekturen, strukturierte Prompts und messbare Ergebnisse machen KI-Coding zu einem nachhaltigen Bestandteil moderner Softwareentwicklung.
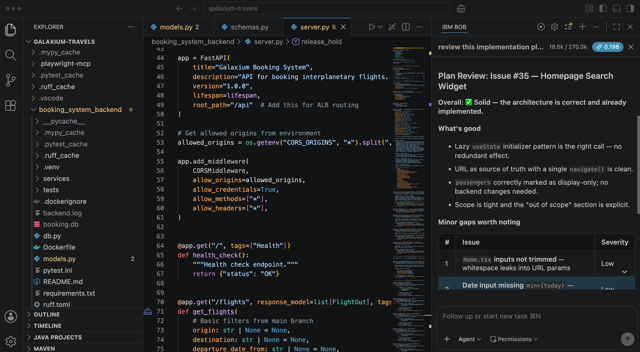
Beispiel für einen Plan-Review (Bild 2)
Autor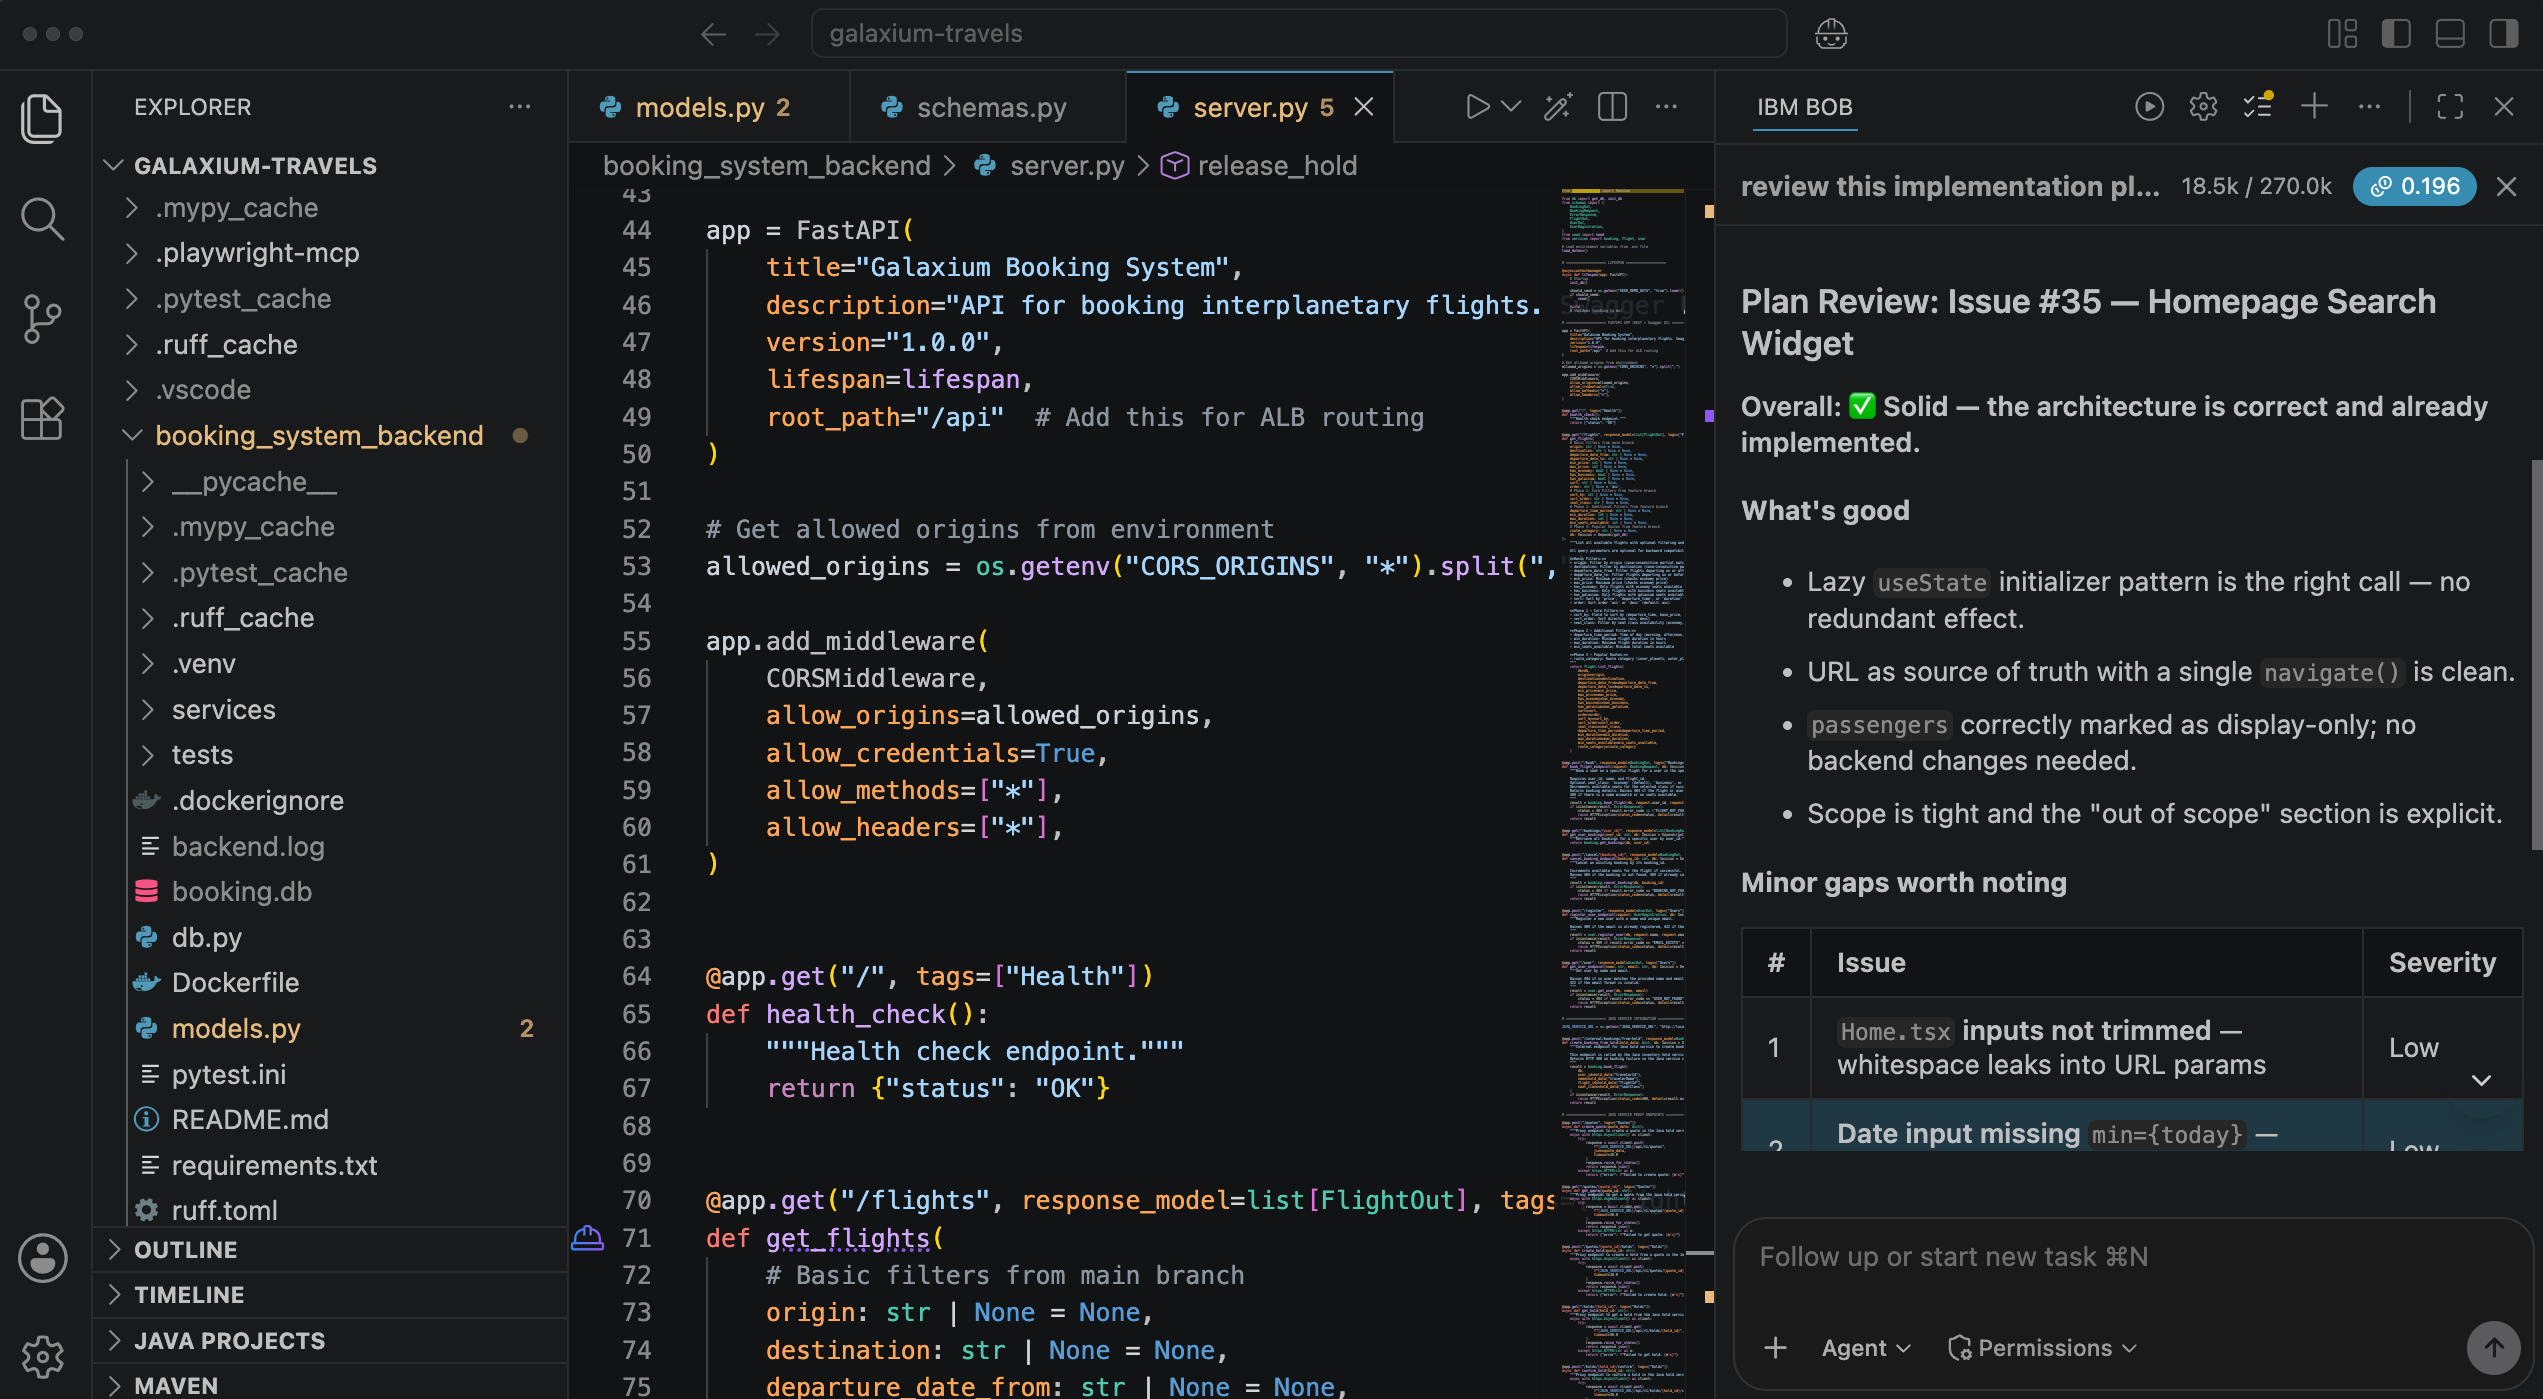
- Token-Schock statt KI-Wonderland
- Das Token-Paradoxon verstehen
- Intelligentes Model-Routing
- Kontext optimieren, statt alles mitzuschicken
- Transparente Abrechnungsmodelle schaffen
- Agentendesign für Effizienz
- Governance und Sicherheit als Teil der Kostenrechnung
- Metriken: Was Teams wirklich messen sollten
- Handlungsempfehlungen für Entwicklerteams und CTOs
- Fazit: Nachhaltige KI-Entwicklung ist gestaltbar